04 / 개인 프로젝트
사내 서버 운영을 가정한 Linux 인프라 구축 · 장애 대응개인
서버 구축부터 모니터링, 자동화, 장애 대응까지 운영 흐름 전 과정 수행
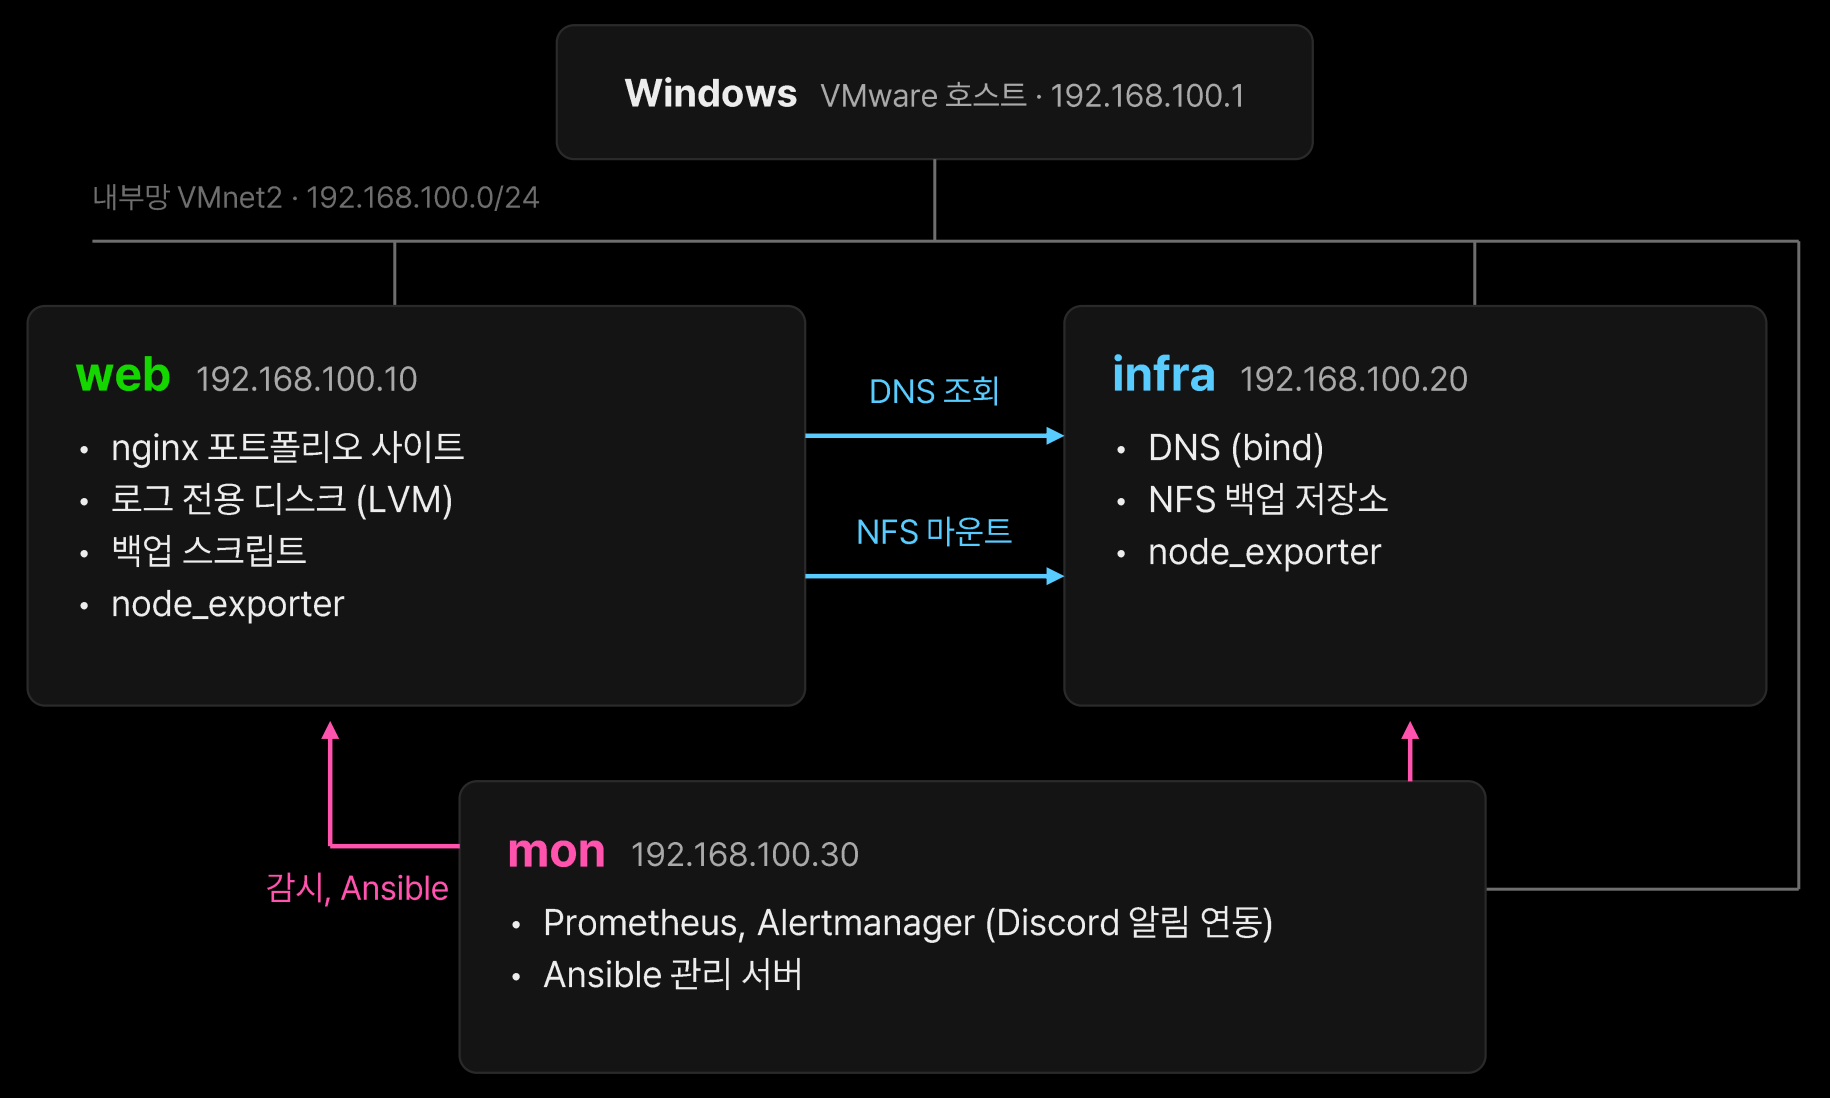
역할(Web · Infra · Mon)과 네트워크(NAT · 내부망)를 분리한 가상 서버 3대 구축
Prometheus · Alertmanager로 7가지 장애 알림을 Discord에 연동
Ansible · Git으로 nginx 설정을 코드화하고 멱등성을 활용한 설정 복구 검증
10종 무작위 장애를 주입해 증상 감지 → 원인 추적 → 조치 순서로 대응
Prometheus 다운로드, Ansible galaxy, 보안 업데이트 실패를 각각 재시도로 넘겨 같은 원인(DNS의 IPv6 질의)이 세 번 반복됨
→ 비슷한 장애가 반복되면 공통 원인부터 확인하고, 간헐적 오류는 재현율로 확인해야 함
구축과 운영 (1~4단계)
- 서버 구축 — 인터넷용(NAT)과 서버 간 통신용(내부망) 네트워크 카드를 분리, 로그 전용 디스크(LVM)로 로그가 가득 차도 OS 디스크 영향 방지, SELinux는 끄지 않고 라벨 지정 → 403 오류 방지
- 내부 DNS와 NFS 공유 — web은 infra만 DNS로 사용하도록 변경, web의 root가 만든 파일은 infra에서 nobody 소유로 저장되는 것 확인(root_squash), 종료는 web → infra · 시작은 infra → web (infra를 먼저 끄면 web 종료 지연)
- 백업과 복구 테스트 — 백업 위치를 infra(NFS)로 두어 web이 고장 나도 백업 보존, 백업(tar)이 실패하면 스크립트가 바로 멈추도록 set -e 사용(새 백업이 없는데 오래된 백업까지 지우는 일 방지), index.html 삭제(복구 시험) → 403, 백업에서 복구 → 200
- 보안 업데이트와 HTTPS — 보안 공지 129건 적용, 재부팅은 mon → web → infra 순서, 자체 서명 인증서로 HTTPS 적용, http로 접속하면 https로 이동(301)
모니터링 알림 규칙 7개 (5단계)
| 알림 규칙 | 조건 |
|---|---|
| InstanceDown | 서버 또는 node_exporter 응답 없음 |
| DiskUsageHigh | 디스크 사용률 80% 초과 |
| ServiceDown | nginx, named 등 필요한 서비스 중지 |
| NFSMountProblem | web의 NFS 마운트 이상 |
| BackupStale | 3시간 넘게 백업 성공 기록 없음 |
| BackupMetricMissing | 백업 기록 없음 |
| CertExpiringSoon | 인증서 만료 30일 이내 |
알림 시험 — 서비스 중지, 백업 실패, 백업 오래됨, 알림 전달 4건 모두 알림 발생 확인
시험 중 발견한 문제 — web은 NFS 서버(nfs-server)를 쓰지 않는데 ServiceDown 알림 발생. 규칙이 모든 서버에서 같은 서비스를 감시한 것이 원인 → 서버마다 감시할 서비스를 나눠 규칙 재작성
Ansible · git 설정 관리 (6단계)
- 플레이북 실행 — changed=0. 플레이북과 web의 실제 상태가 일치
- web 설정 2곳 임의 변경 — https 방화벽 제거, http → https 자동 이동 설정 해제
- 미리보기 (--check --diff) — 바꾼 2곳만 변경 예정으로 표시
- 플레이북 적용 — 2곳만 원래대로 복구
- 한 번 더 실행 — changed=0. 추가 변경 없음
- 접속 확인 — https 200, http 301. 원래 상태와 동일
Ansible 전용 계정 — SSH 키로만 접속, mon에서 오는 접속만 허용, Windows 접속 거부 확인
git 변경 이력 — 변경 순서: 수정 → git diff → 미리보기 → 적용 → 커밋. 사이트에 섞인 내부 파일 2개 발견(README.txt 등), 배포 원본에서 빼도 서버 파일은 남음 → 플레이북에 "없어야 함"(state: absent) 추가, 조치 전 200 → 조치 후 404
무작위 장애 대응 9회 · 10종 (7단계)
| 회차 | 장애 | 원인 서버 | 감지 방법 |
|---|---|---|---|
| 1 | nginx 중지 | web | 알림(ServiceDown) |
| 2 | index.html SELinux 라벨 user_home_t → 403 | web | 사이트 접속(알림 없음) |
| 3 | node_exporter 중지 → 알림 3개 연쇄 | web | 알림(InstanceDown 외) |
| 4 | DNS에 등록된 web 주소 변경 (.10 → .99) | infra | 정상 확인표 대조(알림 없음) |
| 5 | 인증서 이동 → nginx 시작 실패 | web | 알림(ServiceDown) |
| 6 | crond 중지 | web | 알림(ServiceDown) |
| 7 | named 중지 | infra | 알림(ServiceDown) |
| 8 | nfs-server 중지 + 방화벽 런타임 nfs 제거 | infra | 알림(ServiceDown, NFSMountProblem) |
| 9 | 로그 디스크 100%(fill.tmp) | web | 알림(DiskUsageHigh) |
서버 구성도
접근 제한
- SSH — SSH 키 접속만 허용, root 접속 차단
- 9100 (node_exporter) — mon에서만 접속 허용
- 9090, 9093 (모니터링 화면) — Windows에서만 접속 허용
- ansible 계정 — mon에서 오는 접속만 허용
- NFS — web에만 공유
진행 단계
- 0 · 10/07준비 — 계획 수립 및 준비
- 1 · 10/08구축 — VM과 네트워크, SSH 키 접속, LVM 로그 디스크, nginx
- 2 · 10/08내부 서비스 — DNS, NFS 공유, 재부팅 확인, 백업과 복구
- 3 · 10/08장애 연습 — 모의 장애 3종 원인 추적
- 4 · 10/10보안 — mon 추가, 보안 업데이트, HTTPS
- 5 · 10/11모니터링 — Prometheus, Alertmanager, Discord 알림
- 6 · 10/11자동화 — Ansible, git
- 7 · 10/12–13무작위 장애 — 10종 원인 확인과 조치
- 8 · 10/14–15정리 — 문서 정리
알림이 놓친 장애 3가지와 개선 방향
웹 응답 4032회차
알림이 없던 이유nginx는 켜져 있어 서비스 알림이 뜨지 않음
사이트 접속 시 발견
DNS가 틀린 답4회차
알림이 없던 이유DNS 서버는 정상 동작, 답이 맞는지 확인하는 감시 없음
정상 확인표 대조로 발견
방화벽 런타임 규칙 누락8회차
알림이 없던 이유6회차에 주입됐으나 이미 맺어진 NFS 연결은 유지되어 증상 없음
8회차 NFS 서버 재시작 후 새 연결이 막히며 드러남
- 이름으로 새 연결을 맺어 응답을 확인하는 감시 (blackbox_exporter 등)
- 런타임 방화벽 규칙과 영구 규칙을 비교하는 점검